
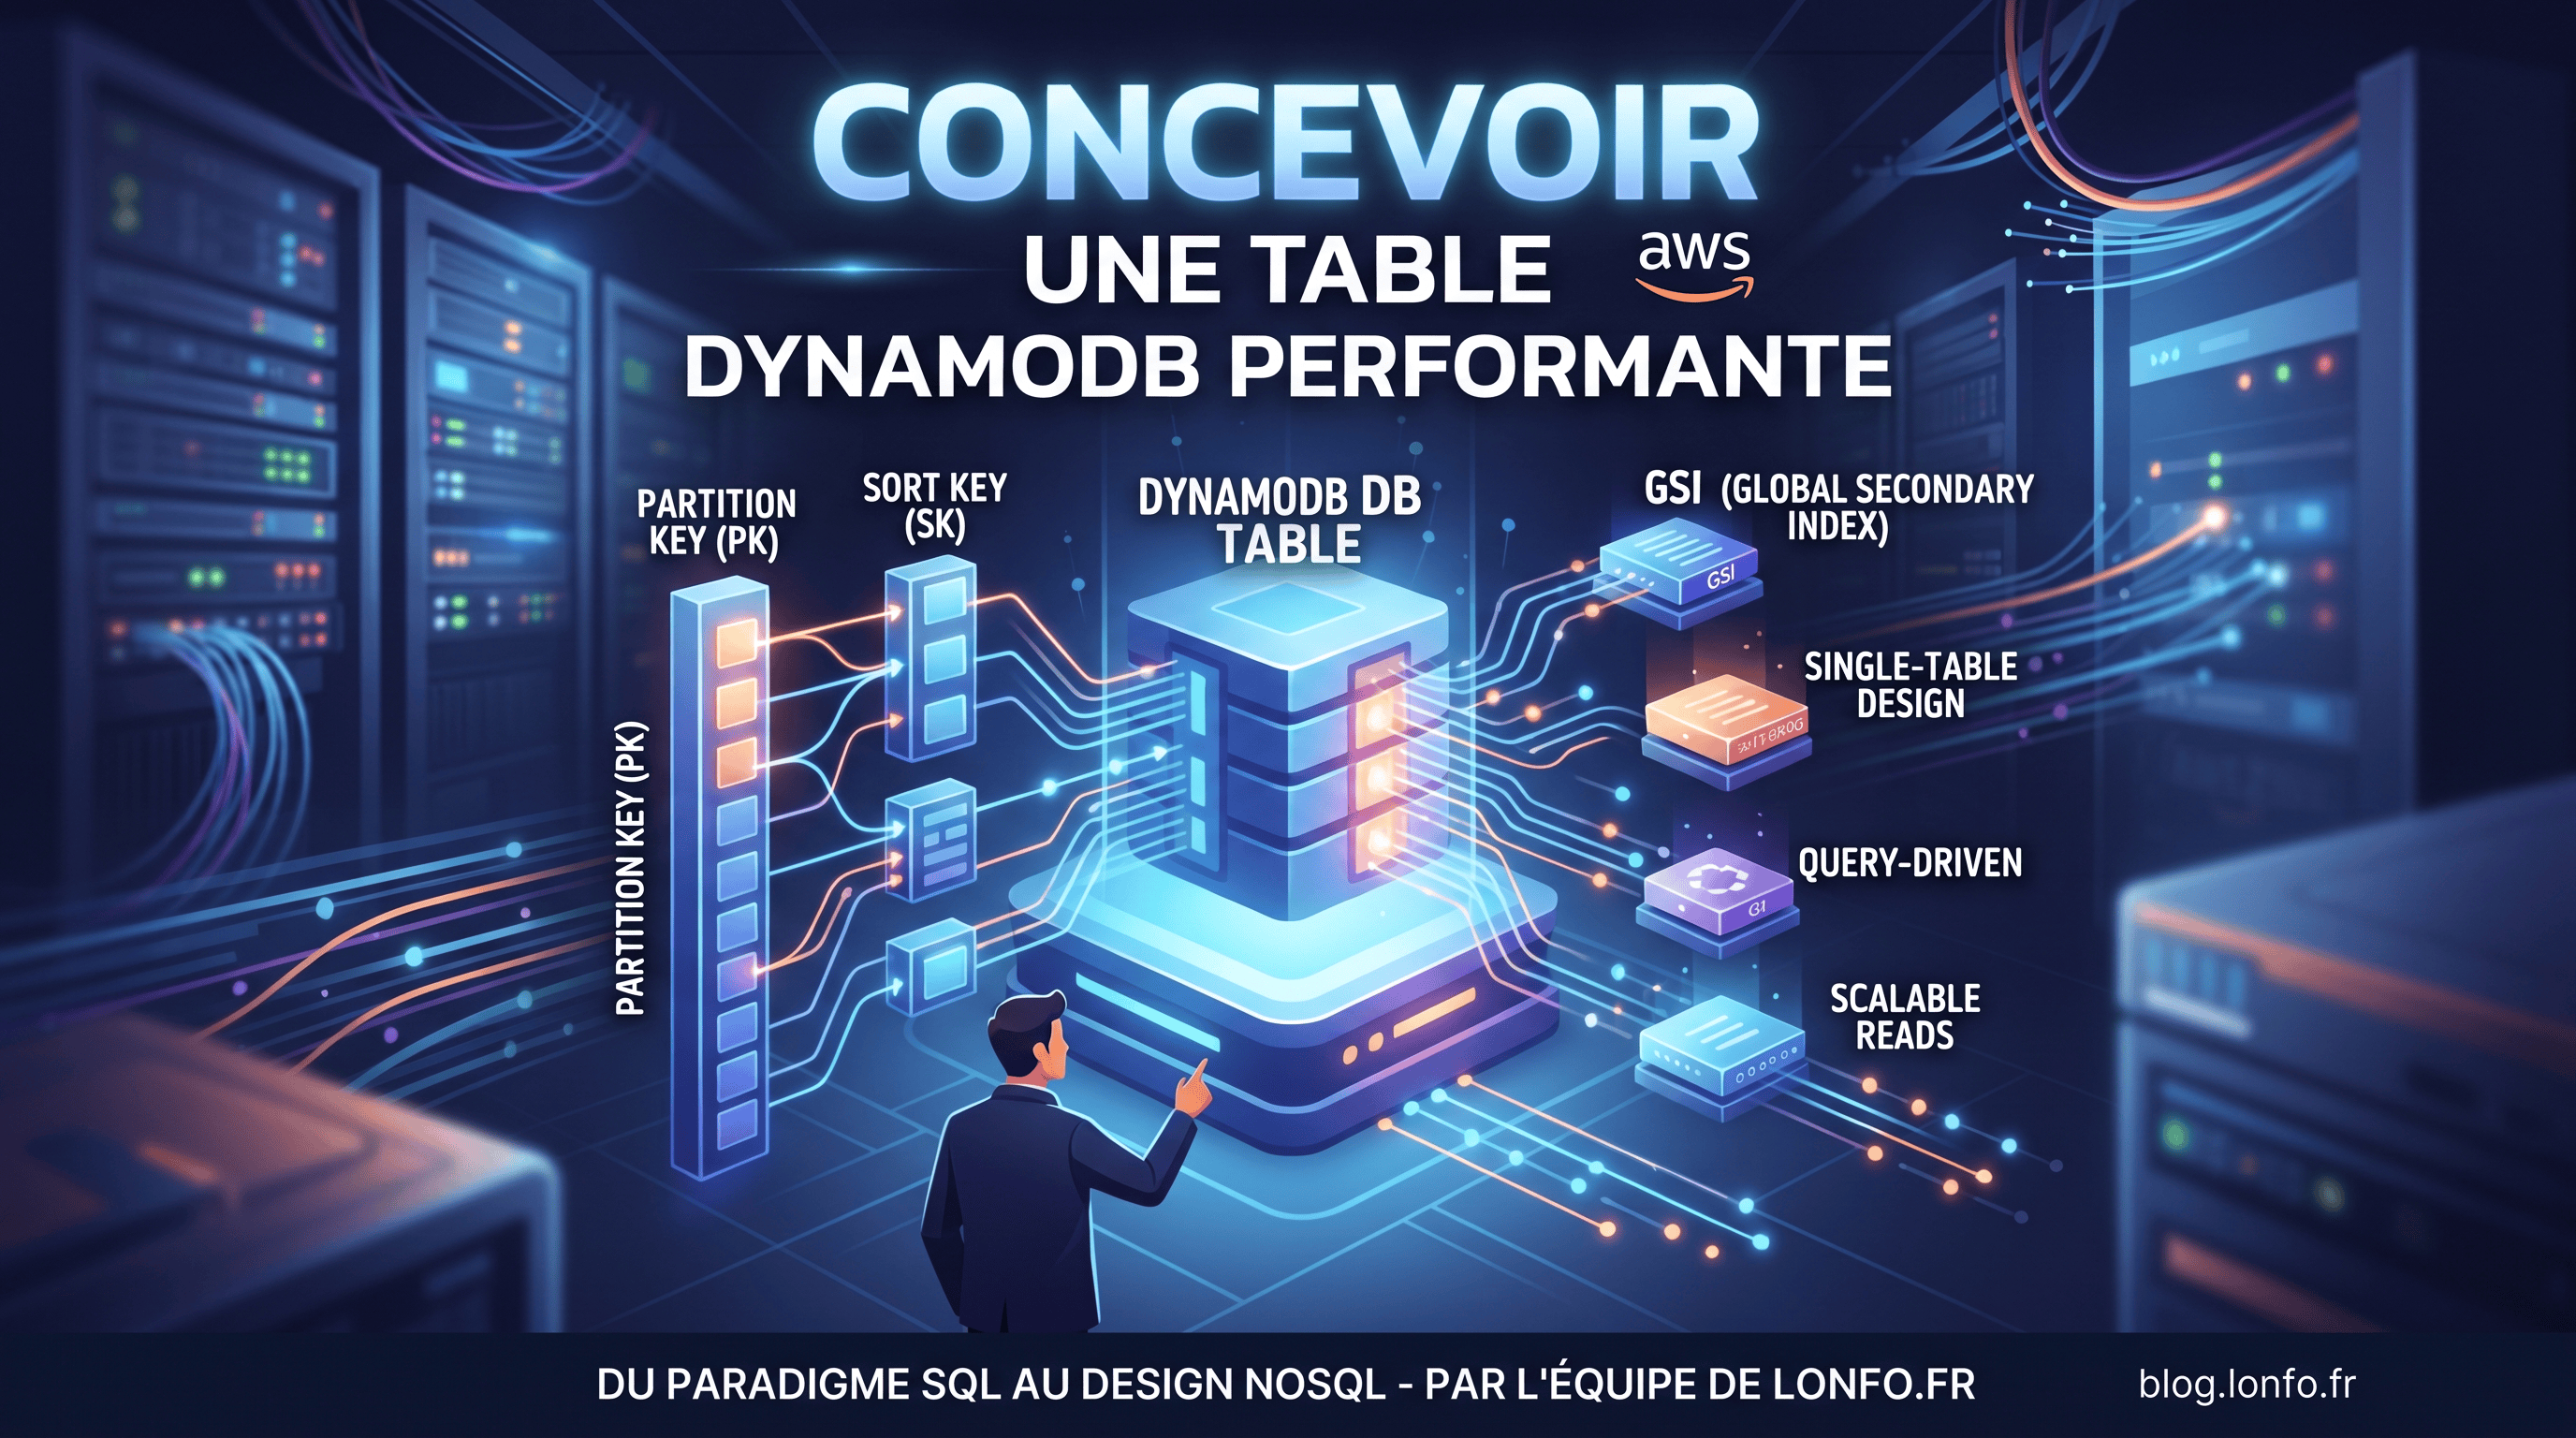
Comment concevoir (ou designer) une table DynamoDB performante ?
Introduction
Si tu arrives dans le monde de DynamoDB avec bagage relationnel (PostgreSQL, MySQL, Oracle), oublie tout ce que tu sais. La première erreur que font 90% des développeurs est de concevoir une base NoSQL comme une base SQL : on crée des tables par entité, on normalise à outrance, et on espère pouvoir faire des JOIN propres plus tard.
Résultat ? C’est le crash assuré en production : performances qui s’effondrent, coûts AWS explosifs et requêtes impossibles.
Contrairement aux bases relationnelles, DynamoDB a été conçu pour une seule chose : fournir des performances ultra-rapides et prédictibles (en millisecondes, voire microsecondes), peu importe l’échelle, du premier au milliardième utilisateur. Pour y parvenir, le paradigme change totalement : on passe d’un design centré sur les données à un design centré sur les requêtes (Query-Driven Design).
À la fin de cet article, tu sauras exactement comment modéliser tes tables DynamoDB comme un architecte cloud aguerri.
1. Le grand changement de paradigme : SQL vs DynamoDB
Pour comprendre comment concevoir une table DynamoDB, il faut d’abord comprendre pourquoi le SQL ne fonctionne pas ici.
En SQL (Relationnel) : Normalisation et Jointures
En SQL, tu optimises le stockage. Tu divises tes données en plusieurs tables pour éviter la duplication : une table users, une table orders, une table order_items.
- Le principe : Tu stockes les données de manière propre, et c’est la base de données qui se débrouille pour reconstituer le puzzle à la volée au moment où tu fais ta requête, en faisant des jointures
JOIN - Le problème avec NoSQL : DynamoDB ne supporte pas les jointures. Si tu dois croiser trois tables pour afficher une simple page de profil, tu devras faire trois requêtes réseau distinctes, ce qui ruine l’intérêt de la vitesse du NoSQL.
En NoSQL / DynamoDB : Dénormalisation et Single-Table
En DynamoDB, tu optimises la lecture.
Le principe inverse : Tu dupliques les données. Tu acceptes de stocker plusieurs fois la même information si cela te permet de la récupérer en une seule et unique opération (appelée Query ou GetItem).
L’objectif absolu : Obtenir l’ensemble des données nécessaires pour rendre une vue de ton application en un minimum d’appels réseau à la base de données.
2. Étape 1 : Analyser les besoins d’accès (Query-Driven Design)
C’est la règle d’or, le commandement numéro un de DynamoDB : Ne commence JAMAIS par dessiner tes tables ou tes colonnes. Si tu commences par te dire “Je vais créer une table Utilisateur avec un nom, un email et une date de création”, tu t’y prends mal. Tu dois commencer par lister toutes les questions que ton application va poser à la base de données.
Méthode pratique :
Prends une feuille (ou un outil de mindmapping) et écris l’ensemble de tes Access Patterns (schémas d’accès). Par exemple, pour une application de e-commerce, ta liste ressemblera à ça
- Récupérer les informations d’un utilisateur grâce à son ID.
- Lister toutes les commandes d’un utilisateur, de la plus récente à la plus ancienne.
- Trouver le détail d’une commande spécifique via son ID.
- Lister les produits disponibles dans une catégorie donnée.
TPourquoi c’est vital ?
En DynamoDB, tu construis ta structure de données en fonction des questions que tu vas lui poser, et non en fonction de la nature intrinsèque des objets. Si un nouveau besoin d’accès arrive plus tard et n’a pas été anticipé, il faudra parfois refondre totalement la modélisation.
3. Étape 2 : Choisir les clés primaires (Primary Keys)
Une fois tes Access Patterns listés, tu dois concevoir la clé primaire de ta table. C’est le moteur de recherche interne de DynamoDB. Contrairement au SQL où tu peux filtrer sur n’importe quelle colonne sans trop y penser, DynamoDB repose entièrement sur sa clé primaire pour trouver physiquement où se trouvent les données. Tu as deux choix principaux :
A. La Clé de Partition simple (Partition Key / HASH)
C’est un identifiant unique (ex: un userId ou un productId).
Comment ça marche ? DynamoDB passe cette valeur à travers une fonction de hachage pour déterminer exactement sur quel serveur physique (partition) se trouve la donnée.
Le piège à éviter : La Cardinalité. Ta clé de partition doit avoir un grand nombre de valeurs possibles et uniques. Si tu mets un attribut comme status avec uniquement deux valeurs (ACTIVE ou INACTIVE), toutes tes données vont s’accumuler sur les mêmes serveurs, créant ce qu’on appelle une Hot Partition (une surcharge critique d’une portion de la base).
B. La Clé Composée : Partition Key + Clé de Tri (Sort Key / RANGE)
C’est là que DynamoDB devient extrêmement puissant. En combinant une Partition Key et une Sort Key, tu crées une hiérarchie de stockage.
- Le principe : Tous les éléments qui partagent la même Partition Key sont stockés physiquement ensemble, et triés par ordre alphabétique ou numérique selon la Sort Key.
- Cas d’usage parfait (Ex: les commandes d’un utilisateur) :
- Partition Key :
USER#123 - Sort Key :
ORDER#2026-06-01T12:00:00Z - Grâce à cela, une simple requête sur USER#123 te permet de récupérer instantanément toutes les commandes de cet utilisateur, triées par date, ou de filtrer par plage de dates (BETWEEN) avec une efficacité redoutable.
- Partition Key :
- Cas d’usage parfait (Ex: les commandes d’un utilisateur) :
## 4. Étape 3 : Utiliser les index secondaires pour multiplier les accès
Tu t’en rends compte rapidement : avec une seule clé primaire (même composée), tu ne peux répondre qu’à un nombre limité de tes Access Patterns. Comment faire si tu dois chercher un utilisateur par son email alors que ta table principale est organisée par userId ?
C’est là qu’interviennent les Index Secondaires. DynamoDB en propose deux types :
A. Les LSI (Local Secondary Index)
- Définition : Un index qui partage la même clé de partition que la table principale, mais utilise une Sort Key différente.
- Contrainte : Il doit être créé obligatoirement à la création de la table et partage la capacité de stockage globale. Ils sont aujourd’hui assez peu utilisés au profit des GSI.
B. Les GSI (Global Secondary Index) — L’arme absolue
Définition : Un GSI est, en gros, une “seconde table virtuelle” indépendante. Il possède sa propre Partition Key et sa propre Sort Key totalement décorrélées de la table principale.
Comment ça marche : DynamoDB réplique de manière asynchrone les données de ta table principale vers le GSI dès qu’une écriture a lieu.
Exemple :
- Table principale optimisée pour : Trouver une commande par
userId. - GSI créé pour : Trouver une commande par
emailDuClient.
- Table principale optimisée pour : Trouver une commande par
Attention aux coûts : Chaque GSI possède ses propres unités de lecture/écriture (RCU/WCU) et duplique l’espace de stockage. Il ne faut les créer que pour des Access Patterns stricts et indispensables.
5. Étape 4 : Les patterns de modélisation avancés
Quand on maîtrise les bases, on peut pousser la logique DynamoDB à son paroxysme avec des architectures de pointe.
A. Le Single-Table Design (La cathédrale du NoSQL)
Dans les applications complexes, la tendance forte est de stocker toutes les entités de l’application dans une seule et unique table DynamoDB (utilisateurs, commandes, produits, factures).
- Comment ? En utilisant des noms de clés génériques (PK et SK) et en préfixant les données. Par exemple :
- Un utilisateur :
PK=USER#123,SK=METADATA - Une commande de cet utilisateur :
PK=USER#123,SK=ORDER#9988
- Un utilisateur :
- Pourquoi ? Cela permet de récupérer le profil de l’utilisateur et ses commandes en une seule requête (Batch ou Query sur la même partition), éliminant toute latence réseau. C’est redoutable de performance, mais demande une rigueur de conception absolue.
B. Le Sparse Indexing (L’indexation éparse)
Un GSI n’indexe que les éléments de la table qui contiennent les attributs définis pour la clé de l’index. Si un item ne possède pas cet attribut, il est tout simplement ignoré par le GSI.
- Astuce de pro : Cela te permet de créer des index extrêmement légers et ultra-rapides pour isoler un sous-ensemble de données (par exemple, uniquement les comptes utilisateurs ayant un statut
PENDING_VALIDATION), ce qui réduit drastiquement les coûts de stockage et de lecture.
Les erreurs fatales à éviter
Avant de basculer ton code en production, vérifie que tu ne commets pas l’une de ces erreurs classiques :
- Le piège du
Scan: LeScanparcoure l’intégralité de ta table, élément par élément, pour trouver ce que tu cherches. C’est l’équivalent d’unSELECT * FROM tablesans WHERE en SQL. Sur une table qui grandit, cela va saturer ta base, faire exploser ta facture AWS et rendre ton application inutilisable. Utilise toujoursQueryouGetItemvia les clés et index. - Négliger la taille des items (Limite de 400 Ko) : Un item (une ligne) dans DynamoDB ne peut pas dépasser 400 Ko. Si tu fais du Single-Table Design et que tu tentes d’y imbriquer des listes infinies (ex: tous les commentaires d’un article de blog stockés dans le même item), tu vas bloquer ton application le jour où le seuil est dépassé. Pour les gros volumes, préfère stocker les éléments lourds dans Amazon S3 et garder seulement l’URL dans DynamoDB.
Conclusion
Concevoir une table DynamoDB demande un véritable changement de perspective : l’application dicte la structure de la base, et non l’inverse. En résumé, pour réussir ton design à coup sûr :
- Liste précisément tous tes besoins d’accès avant de coder.
- Définis une clé primaire composée intelligente si tu as besoin de relations ou de tris.
- Ajoute des GSI ciblant uniquement les requêtes secondaires indispensables.
- Bannis définitivement les
Scan. Une fois ces réflexes acquis, DynamoDB devient l’un des outils les plus jouissifs et scalables de l’écosystème cloud.

Commentaires